GMC-Link
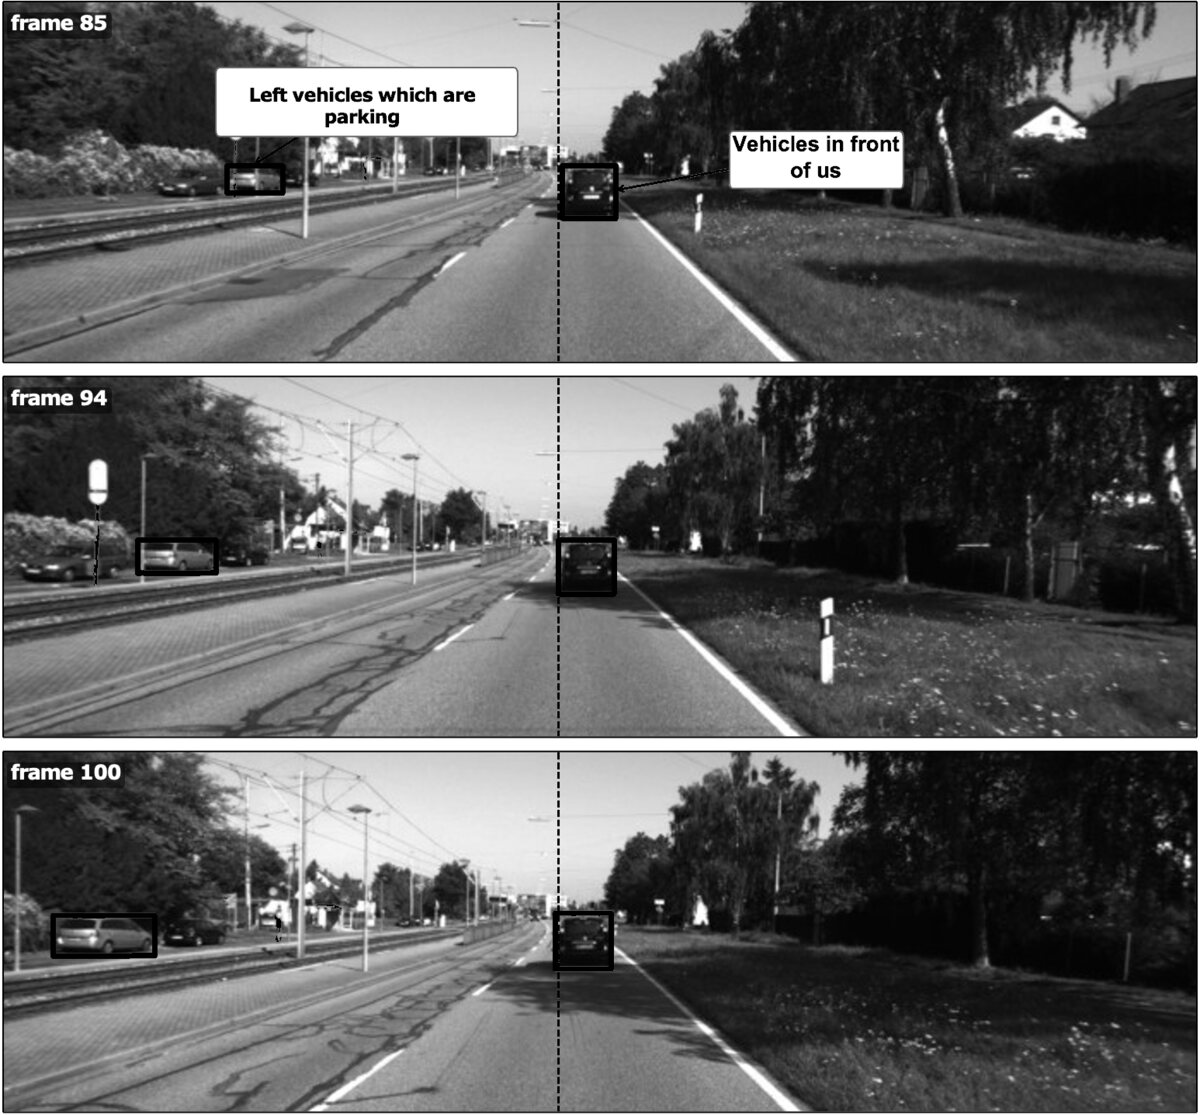
指涉式多目標追蹤(RMOT)吃一段影片和一句話——「正在移動的車」、「停在左邊的車」——然後追蹤所有符合描述的物體。但從行進中的車上拍,停著的車會掃過整個畫面,前方同向行駛的車反而幾乎不動:影像裡看到的運動,跟路上實際發生的剛好相反。
既有的 RMOT 方法從框在影格間的位移讀運動,但這個位移同時混了物體和攝影機的運動——偏偏壞掉的就是「描述運動」的那類語句。傳統 MOT 早就在做攝影機運動補償(BoT-SORT、UCMCTrack),怎麼把它接到語言比對上卻幾乎沒人探討。
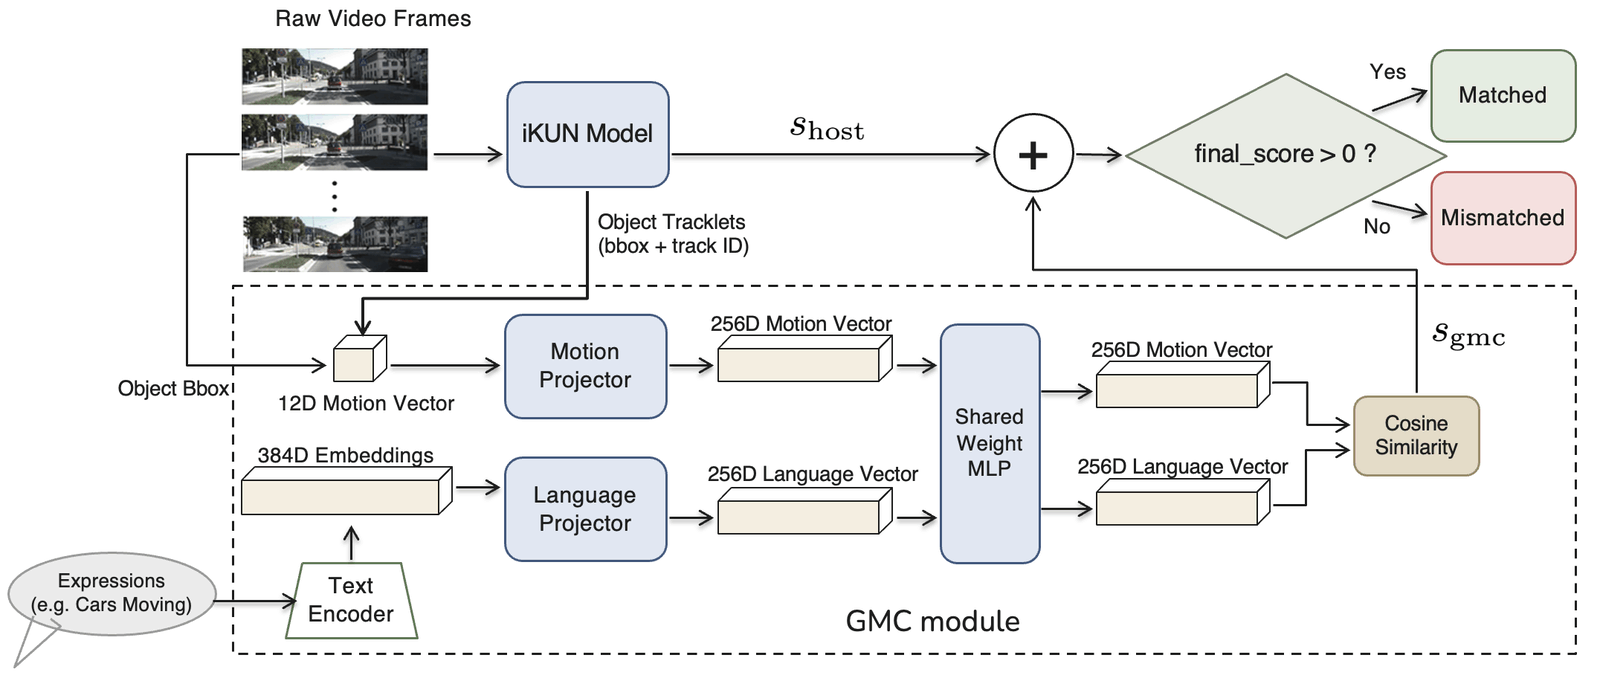
掛在 host 外面的四個階段。在畫面下半部(路面)取 Shi–Tomasi 角點,用金字塔 Lucas–Kanade 追到下一幀,再以 RANSAC 擬合逐幀 homography。把 homography 累乘到 2、5、10 幀的間隔,推算靜止物體「應該」出現在哪裡;觀測速度減掉這個自身運動速度就是殘差速度,三個間隔的殘差速度加上框的幾何資訊組成 12 維運動特徵。運動特徵和凍結的 MiniLM 句向量投影到同一空間,用 InfoNCE 對比學習訓練。最後把餘弦相似度依語句類別加權、加到 host 的分數上——host 的偵測器、追蹤器和編碼器都不用動。
Pooled HOTA 在四組 host 設定(iKUN、TransRMOT,以及 FlexHook 在 Refer-KITTI V1 與 V2)全部上升。以 iKUN 為 host 的 moving-class 語句上,HOTA 從 27.70 升到 37.14(三個 seed,+9.44 ± 0.92);拿掉自身運動補償或多尺度間隔,增益都會顯著縮水(p < 0.01)。增益隨 host 本身的運動理解能力遞減:iKUN +9.44,FlexHook V1 只剩 +0.43。模組本身在 CPU 上跑 149 FPS。